Studenti t-test

Tee hüpoteesikontrolle, et teha kindlaks, kas keskväärtused erinevad statistiliselt oluliselt.

Interaktiivse simulatsiooni laadimine...

mida p < 0,05 tegelikult tähendab

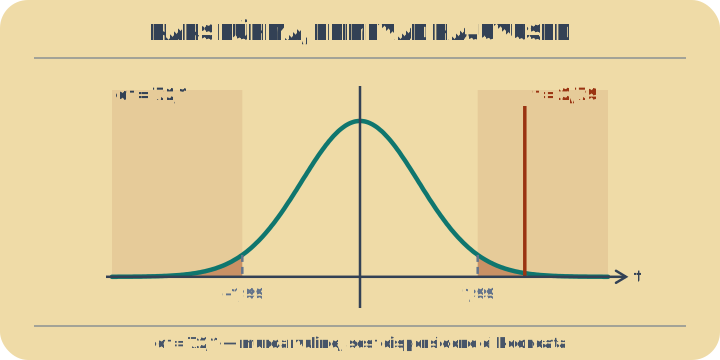
p-väärtus on tõenäosus näha testistatistikut, mis on vähemalt sama äärmuslik kui sinu oma, eeldades, et H₀ on tõene. See EI OLE tõenäosus, et H₀ on tõene. p-väärtus 0,03 tähendab: kui nullhüpotees oleks tõene, näeksid sa nii äärmuslikku tulemust juhuslikult vaid 3% juhtudest — piisavalt ebatavaline, et see tagasi lükata. Kuid 5% olulisuse nivoo tähendab, et 1 test 20-st lükkab tõese nullhüpoteesi tagasi puhtalt juhuse tõttu (I tüüpi viga). Väiksem α on rangem, kuid suurendab II tüüpi vigu (tegelike efektide märkamata jätmist). Graafik näitab seda otse: kui punane joon on üle merevaikkollase piiri, siis p < α.

Keskmiste signaali-müra suhe

Sisuliselt on t-statistik lihtsalt signaali-müra suhe: gruppide keskmiste vahe (signaal) jagatud standardveaga (juhusliku valimi müra). Suur t tähendab, et erinevus paistab hajuvusest selgelt välja; väike t võib kergesti olla juhus. Praktiline õppetund: sama keskmiste vahe muutub veenvamaks, mida suuremad on valimid või mida väiksem nende hajuvus, sest see vähendab müra nimetajas.

Welchi vabadusastmed pole täisarvud

Võiks arvata, et vabadusastmed on korralik täisarv — sõltumatute infoühikute arv. Kuid Welchi t-test kasutab Welch-Satterthwaite'i valemit, mis annab tavaliselt murdarvu nagu df = 17.4. See on tahtlik lähendus: kui rühmade dispersioonid on erinevad, ei leidu täpset täisarvulist df-i, seega interpoleerib meetod, et tegelikku jaotust võimalikult täpselt tabada. Seepärast erineb Welchi df tavaliselt klassikalisest n₁ + n₂ − 2-st.

t-TEST — MILLINE KATSEPLAAN JA MIDA OTSUS TEGELIKULT ÜTLEB?

Millise t-testi juhtumiga on tegemist?

Siin otsustab kõik kaks küsimust. Esiteks katseplaan: kas võrdlete üht rühma väidetud arvuga või kaht rühma omavahel? See määrab valemi ja vabadusastmed. Teiseks lugemisviis: väike p lükkab nullhüpoteesi ümber, suur p seda aga ei tõesta — enamasti tähendab see lihtsalt, et valim oli eristamiseks liiga väike. Mõlemat viga tehakse sagedamini kui arvutusvigu.

Üks valim väidetud väärtuse vastu — tõendus ületab lati t = (x̄ − μ₀) / (s/√n)
Väiksem vahe — otsust ei tule, mis ei tähenda efekti puudumist p > α ⇏ H₀
Kaks sõltumatut rühma — Welch, ilma võrdsete hajuvuste eelduseta SE = √(s₁²/n₁ + s₂²/n₂)
Sama võrdlus, liiga väike võimsus — vahe, mida valim ei suuda eristada 1 − β ∝ δ√n/s

01

Üks valim väidetud väärtuse vastu — tõendus ületab lati

Mida te teate: Üks mõõtmiste rühm ja arv, mille vastu seda kontrollida. Statistik on t = (x̄ − μ₀)/(s/√n) ja vabadusastmeid on n − 1.

Statistik: t = (x̄ − μ₀) / (s/√n)

Näidisarvutus: x̄ = 78 väärtuse μ₀ = 72 vastu, kui s = 8 ja n = 30 → SE = 1,461, t = 4,108, df = 29, p = 0,0003

Ava see juhtum: Eksam (lükka H₀ tagasi)
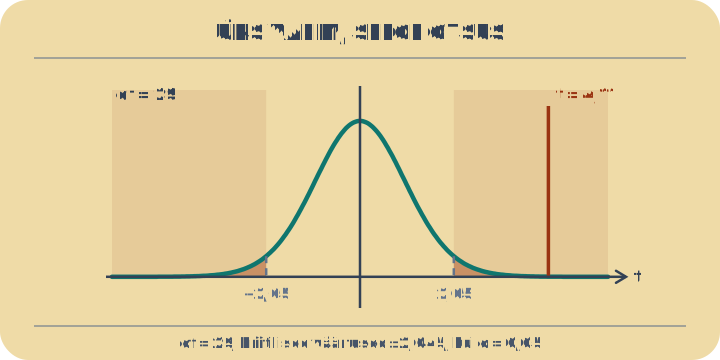
Üks valim väidetud väärtuse vastu — tõendus ületab lati. Vaadeldud t jääb kriitilistest väärtustest kaugele välja, sügavale varjutatud ümberlükkamispiirkonda. Üks mõõtmiste rühm ja arv, mille vastu seda kontrollida. Statistik on t = (x̄ − μ₀)/(s/√n) ja vabadusastmeid on n − 1.
Vaadeldud t jääb kriitilistest väärtustest kaugele välja, sügavale varjutatud ümberlükkamispiirkonda.

02

Väiksem vahe — otsust ei tule, mis ei tähenda efekti puudumist

Mida te teate: Sama katseplaan ja sama n, aga vahe on müra kõrval väike. p jääb α-st suuremaks, nii et nullhüpoteesi ümber ei lükata.

Statistik: p > α ⇏ H₀

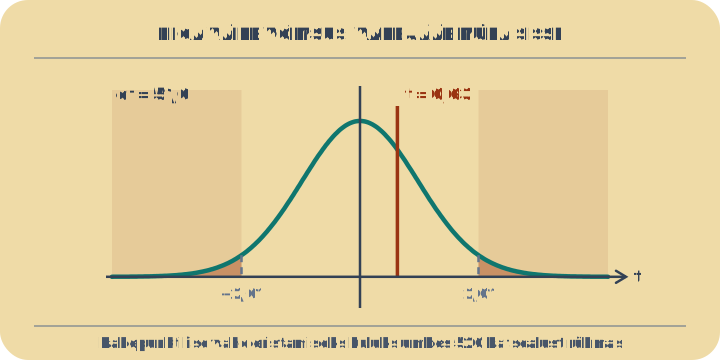
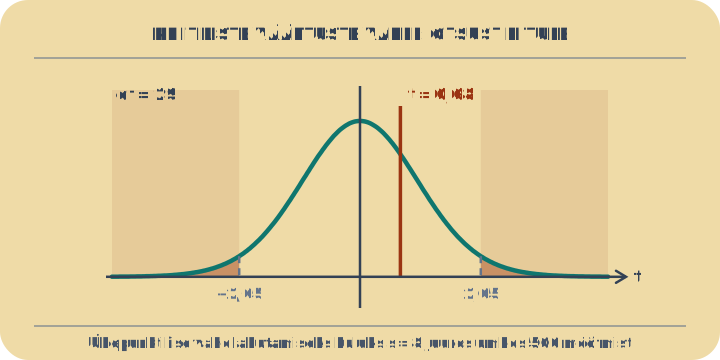
Näidisarvutus: x̄ = 73 väärtuse μ₀ = 72 vastu, kui s = 8 ja n = 30 → t = 0,685, p = 0,499

Ava see juhtum: Eksam (ei lükka tagasi)
Väiksem vahe — otsust ei tule, mis ei tähenda efekti puudumist. Vaadeldud t jääb kriitiliste väärtuste vahele, piirkonda, kus test ei suuda kummalegi poole otsustada. Sama katseplaan ja sama n, aga vahe on müra kõrval väike. p jääb α-st suuremaks, nii et nullhüpoteesi ümber ei lükata.
Vaadeldud t jääb kriitiliste väärtuste vahele, piirkonda, kus test ei suuda kummalegi poole otsustada.

03

Kaks sõltumatut rühma — Welch, ilma võrdsete hajuvuste eelduseta

Mida te teate: Kaks eraldi valimit, igaühel oma keskmine, hajuvus ja maht. SE = √(s₁²/n₁ + s₂²/n₂) ja vabadusastmed tulevad murdarvulised.

Statistik: SE = √(s₁²/n₁ + s₂²/n₂)

Näidisarvutus: 82 ± 10 neljakümnelt katsealuselt 75 ± 12 vastu kolmekümne kaheksalt → SE = 2,508, t = 2,791, df = 72,1, p = 0,0067

Ava see juhtum: Ravimikatse (oluline)
Kaks sõltumatut rühma — Welch, ilma võrdsete hajuvuste eelduseta. Kaks hajuvust, kaks valimimahtu ja df, mis ei ole täisarv — Welchi käekiri. Kaks eraldi valimit, igaühel oma keskmine, hajuvus ja maht. SE = √(s₁²/n₁ + s₂²/n₂) ja vabadusastmed tulevad murdarvulised.
Kaks hajuvust, kaks valimimahtu ja df, mis ei ole täisarv — Welchi käekiri.

04

Sama võrdlus, liiga väike võimsus — vahe, mida valim ei suuda eristada

Mida te teate: Jälle kaks rühma, aga väiksemad ja väiksema vahega. Tulemus ei erista end mürast.

Statistik: 1 − β ∝ δ√n/s

Näidisarvutus: 77 ± 11 kahekümne viielt katsealuselt 75 ± 12 vastu kahekümne kaheksalt → SE = 3,160, t = 0,633, df = 51,0, p = 0,530

Ava see juhtum: Ravimikatse (mitteoluline)
Sama võrdlus, liiga väike võimsus — vahe, mida valim ei suuda eristada. Vaadeldud t on peaaegu jaotuse keskel, seal kus asub peaaegu kogu tõenäosus. Jälle kaks rühma, aga väiksemad ja väiksema vahega. Tulemus ei erista end mürast.
Vaadeldud t on peaaegu jaotuse keskel, seal kus asub peaaegu kogu tõenäosus.

Ülesanne täielikult lahendatud

  1. 30-liikmeline valim tulemusega 78, kui üldkogumi keskmine on 72 5 sammu

    30-elemendilise valimi keskmine on 78, kui väidetav populatsiooni keskmine on 72 ja s = 8. Tee test — ja seejärel vasta küsimusele, millele p-väärtus ei vasta.

    1. Üksik keskmine on mürarikas hinnang ja selle müra on standardviga — valimi hajuvus jagatud valimi suuruse ruutjuurega. Suuremad valimid ei muuda indiviide vähem varieeruvaks; need muudavad keskmise vähem varieeruvaks.

      SE=sn=830=1.4606\text{SE}=\frac{s}{\sqrt{n}}=\frac{8}{\sqrt{30}}=1.4606
    2. t-statistik küsib, mitu standardviga eraldab seda, mida nägid, sellest, mida väideti. See on kaugus, mida mõõdetakse selle enda määramatuse ühikutes.

      t=xˉ−μ0SE=78−721.4606=4.1079t=\frac{\bar{x}-\mu_0}{\text{SE}}=\frac{78-72}{1.4606}=4.1079
    3. Vabadusastmeid on ühe võrra vähem kui valimi suurus, sest valimi keskmine on juba ära kulutatud keskme hindamiseks. Ülalolev kalkulaator väljastab nii selle kui ka statistiku.

      df=n−1=29\text{df}=n-1=29
    4. p-väärtus on nii suure |t| tõenäosus, kui väide oleks tõene. Tööriist väljastab 0.0002982 — umbes 3 juhtumit 10 000-st.

      p=P(∣T29∣>4.1079)=0.0002982p=P(|T_{29}|>4.1079)=0.0002982
    5. Nüüd see osa, mille suhtes p-väärtus vaikib: kui suur on erinevus. Coheni d jagab andmete hajuvusega, mitte keskmise hajuvusega, ega kahane seega valimi kasvades.

      d=xˉ−μ0s=68=0.75d=\frac{\bar{x}-\mu_0}{s}=\frac{6}{8}=0.75

    Vastus

    t = 4.1079 29 df korral, p = 0.0002982. Efekti suurus on d = 0.75, mis on tõeliselt suur erinevus. Nende kahe eristamine ongi kogu teadusharu tuum: p vastab küsimusele "kas see võiks olla müra?" ja seda saab teha meelevaldselt väikeseks rohkem andmeid kogudes, sest n esineb standardveas. d vastab küsimusele "kas see on oluline?" ja see ei muutu koos n-iga. Uuring n = 10 000 korral võib raporteerida p < 0.001 korral d väärtuseks 0.02 — statistiliselt kindel, praktiliselt olematu.

    t=4.1079, df=29, p=0.0002982d=0.75t=4.1079,\ \text{df}=29,\ p=0.0002982\qquad d=0.75

Õpitee

Millal on erinevus tegelik?

Allikad (1)